Ceph, replikacja ZFS i zewnętrzny SAN lub NAS mogą pomóc maszynom Proxmox przetrwać awarię hosta. Różnią się jednak aktualnością danych, wznowieniem pracy i domeną awarii. Samo zaznaczenie „wysoka dostępność” często zasłania wymóg: ile minut utraty danych aplikacja toleruje (RPO) i kiedy ma być znów użyteczna (RTO)?
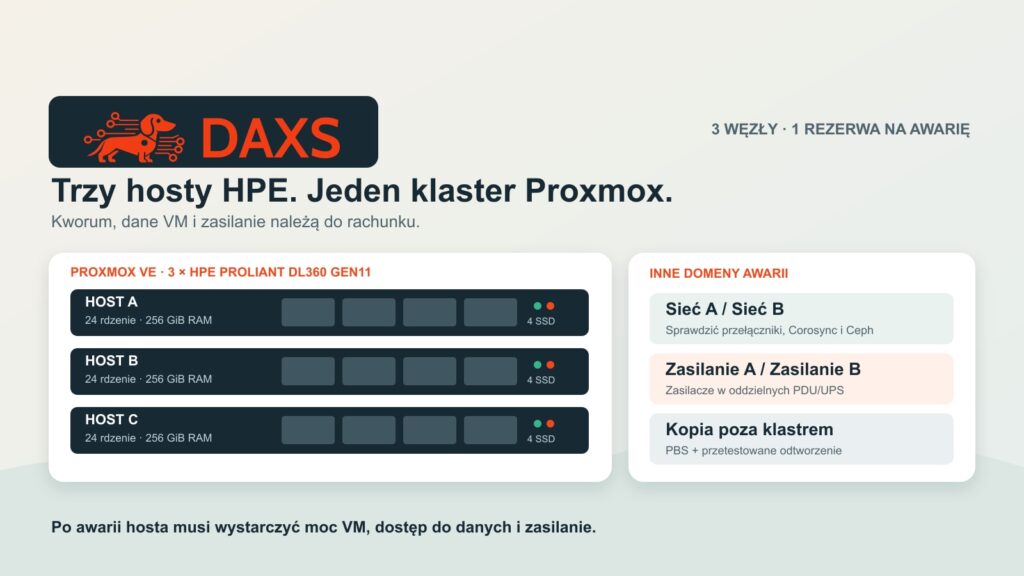
Porównujemy trzy drogi przechowywania dla tego samego hipotetycznego klastra trzech hostów. Jak Ceph odbudowuje kopie po awarii hosta opisano oddzielnie. Tutaj decyzja zaczyna się od aplikacji i sprawdzalnych celów odtwarzania. Każda droga wymaga dodatkowo osobnego backupu z testem odtworzenia.
Trzy architektury, trzy różne ścieżki awarii
Ceph na lokalnych SSD udostępnia dysk VM jako rozproszoną pamięć blokową dostępną w klastrze. Replikowana pula ma kopie na wielu hostach; kworum, reguła puli, sieć i wolna pojemność muszą pasować do wybranej domeny awarii hosta. Po awarii hosta VM Proxmox HA może uruchomić ją na innym, jeśli są kworum i zasoby. Trwający zapis, aplikacja gościa i transakcje nadal wymagają oceny w teście. Sama redundancja Ceph nie obiecuje nieprzerwanej VM ani gwarantowanego zerowego RPO każdej aplikacji.
Lokalny ZFS z replikacją pamięci Proxmox przenosi woluminy VM okresowo przez migawki na drugi host. Cel ma stan ostatniej pomyślnie zakończonej replikacji. Proxmox dopuszcza HA z tą replikacją, ale wyraźnie ostrzega o możliwej utracie danych od ostatniej synchronizacji. Ustawiony interwał pięciu minut nie jest więc ogólną obietnicą RPO: liczą się opóźnienia, nieudane zadania i stan aplikacji. Bez synchronicznego wspólnego dysku uruchomiona ponownie VM musi obsłużyć właśnie ten starszy stan.
Zewnętrzna współdzielona pamięć jak NFS lub iSCSI udostępnia dyski VM wielu hostom i zwykle pozwala migrować na żywo bez kopiowania dysku. Przy awarii hosta ryzyko danych zależy od faktycznego projektu pamięci. Sprawdzić dwa kontrolery, oddzielne tory danych i zasilania, multipathing iSCSI lub redundantne ścieżki NFS, wsparcie i przetestowane przełączenie kontrolera; pojedynczy NAS pozostaje centralną domeną awarii. Dokumentacja Proxmox wyraźnie ostrzega, by urządzenie ZFS-over-iSCSI nie stało się pojedynczym punktem awarii. „Shared” w konfiguracji nie dowodzi redundantnego urządzenia.
Które obciążenie toleruje jakie RPO i RTO?
RPO mierzy maksymalną akceptowaną utratę danych, RTO maksymalny czas do użytecznej aplikacji. Poniższe punkty to pytania decyzyjne, nie SLA produktów. Dla każdej usługi trzeba łącznie testować bazę, restart VM, DNS, logowanie i zależne systemy.
| Aplikacja i cel | Prawdopodobna droga | Decydująca kontrola |
|---|---|---|
| Transakcyjna baza ERP; niemal żadna utrata danych nie jest dopuszczalna | Ceph lub dowodnie redundantna pamięć współdzielona; ewentualnie dodatkowa replikacja aplikacji | Opóźnienie zapisu, spójność transakcji, kworum i realny restart przy awarii hosta/pamięci |
| Wewnętrzna VM testowa lub odtwarzalna usługa WWW; minuty utraty akceptowane | Lokalny ZFS z replikacją może wystarczyć | Wiek ostatniej poprawnej migawki, alarm opóźnienia, start ze starszymi danymi |
| Istniejący wspierany SAN/NAS z wystarczającą rezerwą | Dalsze użycie jako pamięci współdzielonej może być opłacalne | Testować łącznie kontrolery, ścieżki, zasilanie, firmware, umowę serwisową i przełączenie na żywo |
Dla bazy produkcyjnej z bardzo ścisłym RPO asynchroniczna replikacja ZFS może być nieodpowiednia, nawet gdy restart HA działa. Odtwarzalna usługa testowa nie uzasadnia z kolei automatycznie Ceph. Trzy hosty Proxmox nie czynią pojedynczego serwera pamięci redundantnym. Wybór wynika z akceptowanej utraty danych i zmierzonej przerwy, poza nazwą produktu.
Rachunek na trzy i pięć lat bez fikcyjnych cen rynkowych
Hipotetyczne porównanie zakłada trzy identyczne jednogniazdowe hosty z ceną zakupu h na host i osobny serwer kopii z nośnikami w cenie b . Według aktualnej listy producenta Proxmox VE Standard kosztuje 550 € za obsadzone gniazdo CPU rocznie, Proxmox Backup Server Standard 2 240 € za serwer rocznie. Wspólny blok wsparcia wynosi więc 3 × 550 + 2 240 = 3 890 € rocznie. Model przyjmuje 90 € netto za roboczogodzinę. Nie zakłada bez sprawdzenia równych IOPS ani pojemności użytkowej: realne oferty trzeba najpierw znormalizować do tego samego obciążenia.
d oznacza dodatkowe SSD danych Ceph na host, z lokalne wyposażenie SSD ZFS na host, a zewnętrzne urządzenie zaprojektowane redundantnie, nc, nz i ns odpowiednie inwestycje w sieć lub fabric. ec, ez i es to roczne dodatkowe koszty energii/kolokacji; s oznacza roczną umowę serwisową producenta urządzenia zewnętrznego. Litery są kwotami ofertowymi netto w euro, nie twierdzeniami o cenach rynkowych.
| Droga | Instalacja / roczne utrzymanie | 3 lata | 5 lat |
|---|---|---|---|
| Ceph | 80 h / 50 h | 3h + b + 3d + nc + 32 370 + 3ec € | 3h + b + 3d + nc + 49 150 + 5ec € |
| Replikacja ZFS | 50 h / 30 h | 3h + b + 3z + nz + 24 270 + 3ez € | 3h + b + 3z + nz + 37 450 + 5ez € |
| Zewnętrzna pamięć | 60 h / 35 h | 3h + b + a + ns + 26 520 + 3s + 3es € | 3h + b + a + ns + 40 600 + 5s + 5es € |
Godziny to wyłącznie założenia modelu, nie ryczałt DAXS. Przykład: roczny serwis urządzenia droższy o 1 000 € zwiększa wariant zewnętrzny o 3 000 € przez trzy lata i 5 000 € przez pięć. Istniejące urządzenie może zmniejszyć a w tym okresie, ale pozostały czas życia, wsparcie, części i rozbudowa należą do s lub osobnej pozycji inwestycji. Ceny sprzętu, zużycie pojemności, profil wydajności, sieć, podatek i lokalizacja muszą mieć potwierdzenie w ofertach. Najniższy wynik wzoru bez tej samej pojemności użytkowej, IOPS, RPO i RTO nie jest decyzją zakupową.
Odbiór: naprawdę przećwiczyć awarię każdej domeny
DAXS wymagałby czterech dowodów dla każdej architektury: (1) zapisać czas ostatniego spójnego stanu aplikacji, (2) zmierzyć awarię hosta i restart VM z obciążeniem, (3) celowo wyłączyć też krytyczną ścieżkę pamięci lub sieci i (4) odtworzyć VM oraz pojedyncze dane aplikacji z osobnej kopii. Dla ZFS uwzględnić nieudane lub opóźnione zadanie replikacji; dla Ceph zdegradowaną pulę i jej odbudowę; dla SAN/NAS przełączenie kontrolera i ścieżki. Dopiero pomiary decydują o spełnieniu RPO i RTO.
Kopie Ceph, migawki replikacji i lustra macierzy przenoszą też usunięcia i błędne dane. Nie zastępują wersjonowania, zewnętrznej kopii ani testu odtworzenia. Artykuł DAXS Proxmox Backup Server: weryfikacja, retencja i odtwarzanie rozwija odbiór backupu. Z listą aplikacji i celów RPO/RTO można przez Kontakt zlecić DAXS pomiar trzech dróg przy rzeczywistym obciążeniu i istniejących umowach.
Źródła: Proxmox VE Administration Guide: pamięć, replikacja pamięci i HA · Proxmox VE: aktualne ceny wsparcia · Proxmox Backup Server: aktualne ceny wsparcia.