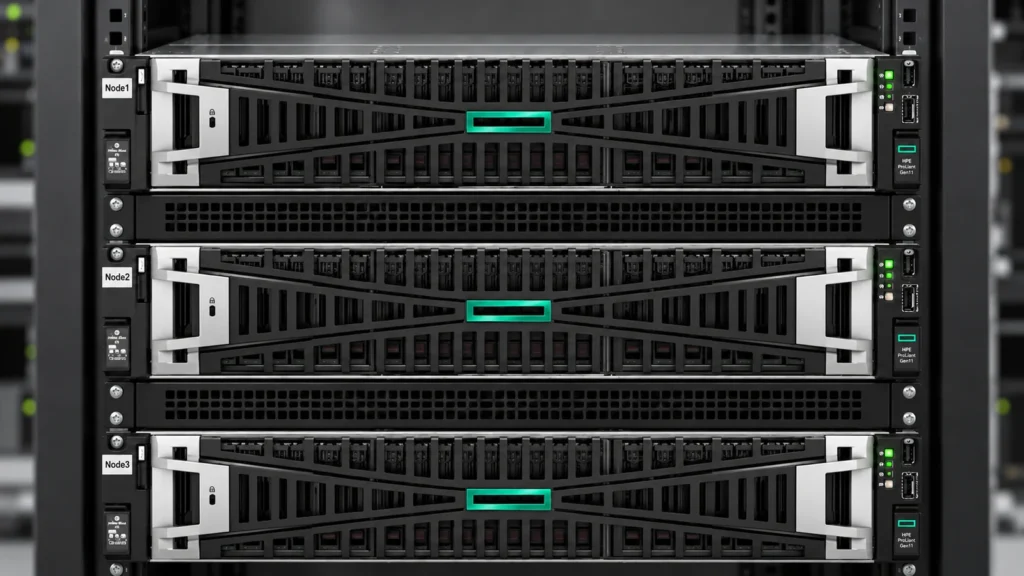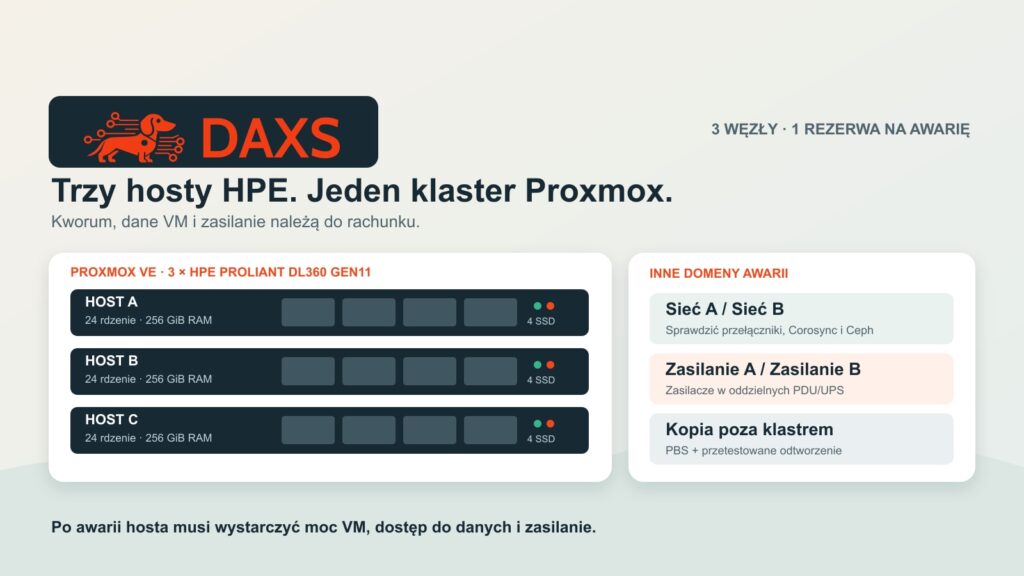
Trzy serwery rack HPE same nie tworzą odpornego klastra Proxmox. Cel można sprawdzić dopiero wtedy, gdy po awarii węzła pozostają wystarczające moc obliczeniowa, pamięć, dostępne dane VM, sieć i ścieżki zasilania. Przykład pokazuje decyzje potrzebne dla klastra Proxmox VE z trzema HPE ProLiant DL360 Gen11.
Artykuł opisuje hipotetyczny profil doboru zasobów, nie gotowy numer zamówieniowy HPE. Na węzeł przyjęto procesor z 24 rdzeniami, 256 GiB RAM ECC, lustrzane nośniki startowe, cztery korporacyjne SSD SAS po 3,84 TB na dane VM, dwa redundantne zasilacze i odpowiednie łącza 25 Gbit. HPE oferuje DL360 Gen11 jako serwer rack z opcjami CPU, DIMM, dysków, sieci i zasilania. Zatwierdzenie dokładnego zestawu CPU, backplane, trybu HBA/JBOD, SSD, wentylatorów, NIC, kabli i firmware wymaga listy materiałowej i kontroli zgodności potwierdzonych przez partnera HPE. Dyski OSD Ceph nie mogą być ukryte za nieodpowiednią macierzą sprzętową RAID.
Czy rezerwa wystarczy po awarii hosta?
Trzy węzły oferują 72 fizyczne rdzenie i 768 GiB RAM brutto. Po awarii jednego pozostaje 48 rdzeni i 512 GiB. W przykładzie na każdym pozostałym hoście rezerwujemy cztery rdzenie i 32 GiB dla Proxmox, Ceph oraz szczytów operacyjnych. Dla VM zostaje zatem obliczeniowo 40 ekwiwalentów rdzeni i 448 GiB RAM. Zmierzony szczyt 28 ekwiwalentów rdzeni i 300 GiB RAM VM pozostawiłby w tym modelu margines 12 ekwiwalentów rdzeni i 148 GiB. Sama liczba vCPU nie jest pomiarem: CPU steal, NUMA, I/O, zajętość RAM i rozmieszczenie pojedynczych dużych VM trzeba zbadać w pilotażu. Do odbioru należą też czas ponownego uruchomienia i priorytety aplikacji.
Do wiarygodnego kworum w trybie HA Proxmox potrzebuje co najmniej trzech głosów. Przy trzech równorzędnych węzłach po awarii jednego pozostają dwa głosy, czyli większość. Nie gwarantuje to jeszcze restartu VM: dane muszą być dostępne, host docelowy musi mieć zasoby, a reguły HA muszą pasować. Corosync wymaga stabilnych niskich opóźnień i niezależnej drugiej ścieżki. Awaria wspólnego przełącznika lub wspólnej PDU niweczy zamierzoną redundancję hostów.
Lokalne SSD: jakie dane pozostają dostępne po awarii?
W tym przykładzie dwanaście lokalnych SSD tworzy pulę Ceph z trzema kopiami i hostem jako domeną awarii. Surowa pojemność wynosi 3 × 4 × 3,84 = 46,08 TB . Trzy kopie zmniejszają teoretyczną pojemność użytkową przed metadanymi i rezerwami do 15,36 TB. Przy limicie ustalonym wyłącznie na potrzeby planowania wynoszącym 70% otrzymujemy wartość roboczą około 10,75 TB. Nie jest to gwarantowana pojemność Ceph: zapełnienie OSD, rozkład, odtwarzanie, snapshoty i rzeczywiste wzorce danych należy zmierzyć.
Po awarii jednego z trzech hostów dwie pozostałe kopie mogą nadal obsługiwać I/O przy właściwie skonfigurowanej regule min_size; pula jest wtedy zdegradowana. Trzecią kopię w trzeciej domenie awarii hosta można przywrócić dopiero po powrocie lub zastąpieniu węzła. To ograniczenie konstrukcji z dokładnie trzema węzłami. Replikacja Ceph nie zastępuje też niezależnej kopii zapasowej. Proxmox Backup Server powinien znajdować się poza tymi trzema hostami, we własnej domenie awarii, z przetestowanym odtwarzaniem i dodatkową kopią zewnętrzną. Artykuł DAXS Proxmox Backup Server: weryfikacja, retencja i odtwarzanie rozwija temat testu odtworzenia.
Sieć i zasilanie jako część architektury
Dla Ceph ważne są przepustowość i małe opóźnienia; dla nowego klastra planujemy oddzielne, redundantnie podłączone ścieżki 25 Gbit jako sprawdzalne założenie wyjściowe. Potrzebna szybkość wynika z obciążenia zapisem, ruchu replikacji i docelowego czasu odtwarzania, a nie z liczby portów w katalogu. Corosync powinien korzystać z niezależnych dróg fizycznych; zarządzanie i ruch VM są odpowiednio rozdzielane lub ograniczane. Dokładne przypisanie VLAN, przełączników i NIC dokumentuje plan portów.
Dwa zasilacze pomagają tylko przy oddzielnych drogach zasilania. DAXS zleciłby podłączenie zasilacza A każdego hosta do PDU/UPS A, a zasilacza B do PDU/UPS B, kontrolę poboru pod obciążeniem i próbę utraty jednej ścieżki. Zarządzanie iLO, zapasowe SSD, utrzymanie firmware i okna serwisowe są dalszymi pozycjami operacyjnymi. Trzy serwery w jednej szafie nie chronią przed awarią całego pomieszczenia.
Otwarty rachunek na trzy i pięć lat
Niech aktualnie potwierdzona oferta HPE za w pełni wyposażony węzeł wynosi h euro, redundantna sieć z optyką n, a niezależny serwer kopii z nośnikami k. Serwis HPE i części kosztują w modelu s euro rocznie, prąd i housing e euro rocznie. Tych wartości ofertowych nie wymyślamy. Opublikowane cenniki Proxmox podają 550 € rocznie za obsadzone gniazdo VE i 2 240 € za serwer PBS Standard: tutaj 3 × 550 + 2 240 = 3 890 € rocznie. Hipotetycznie przyjmujemy jednorazowo 80 godzin po 90 € (7 200 €) na budowę, testy i przekazanie; rocznie 50 godzin po 90 € (4 500 €) na eksploatację.
| Pozycja | 3 lata | 5 lat |
|---|---|---|
| Węzły, sieć, sprzęt kopii zapasowych | 3h + n + k | 3h + n + k |
| Jednorazowa budowa | 7 200 € | 7 200 € |
| VE/PBS + eksploatacja rocznie | 3 × (3 890 + 4 500 + s + e) | 5 × (3 890 + 4 500 + s + e) |
| Razem | 3h + n + k + 32 370 + 3s + 3e € | 3h + n + k + 49 150 + 5s + 5e € |
Wrażliwość widać bezpośrednio: 1 000 € więcej za węzeł zwiększa oba horyzonty o 3 000 €; 1 000 € więcej rocznego serwisu HPE o odpowiednio 3 000 i 5 000 €. Jeżeli każdy host potrzebuje drugiego obsadzonego procesora, na tym samym poziomie Proxmox Standard same subskrypcje dodają 1 650 € rocznie, plus sprzęt, RAM i energia. Rachunek nie obejmuje migracji z VMware, drugiej lokalizacji kopii ani wzrostu cen; pozycje te trzeba dodać do konkretnej decyzji.
DAXS sprawdza najpierw szczyty obciążenia i cele awaryjne, następnie zatwierdzoną listę HPE, plan portów i zasilania, odtwarzanie Ceph i kopii oraz pełne oferty. Aby zaplanować taki klaster w swoim środowisku, można skorzystać z Kontaktu i rozpocząć rozmowę.
Źródła: HPE ProLiant DL360 Gen11 QuickSpecs · Proxmox VE Administration Guide: klaster, HA i Ceph · Ceph: liczba kopii i min_size · Proxmox VE: ceny subskrypcji · Proxmox Backup Server: ceny.